如果你搜索“5豆包ai生成视频”,真实需求大概率不是想了解一个抽象概念,而是想知道:豆包这类 AI 工具生成视频时,提示词到底怎么影响画面,为什么同一句话有时能出片、有时效果很飘,以及怎样描述才能更接近想要的成片。
可以先用一句话理解:AI 生成视频不是简单把文字“翻译”成视频,而是模型根据提示词中的主题、动作、场景、风格和镜头信息,推断出一段连续画面。提示词越清楚,模型可误解的空间越小;但即使描述很完整,也不等于一定能得到完全可控的专业成片。
需要说明的是,本文不假设某个具体版本的豆包当前一定开放了哪些视频功能、支持多长时长或有什么收费规则。这里重点解释 AI 生成视频的通用逻辑,以及写提示词和判断结果的实用方法。
1. 豆包 AI 生成视频可以怎么理解
从用户角度看,AI 生成视频通常包含三个层次:
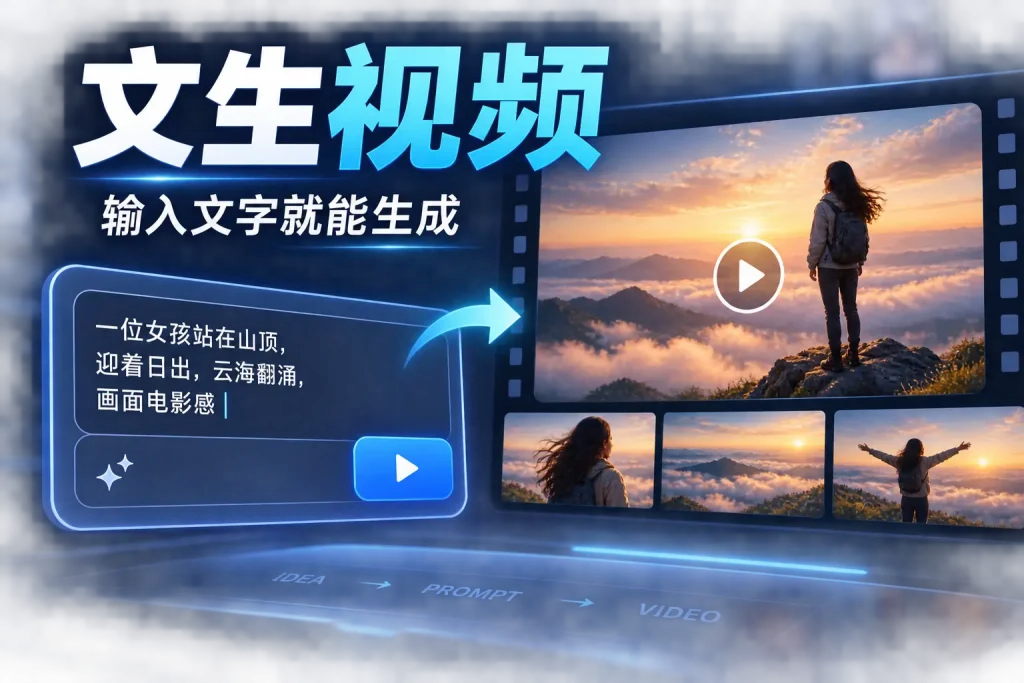
- 你输入文字:例如“一个女孩在雨夜街头撑伞行走,电影感”。
- AI 理解画面:它会识别主体、环境、动作、氛围、风格等信息。
- AI 输出视频:模型生成一段有时间变化的画面,让人物、镜头或环境产生连续运动。
这里最重要的是“连续”。图片生成只需要在一个瞬间里把画面说通,而视频生成还要处理前后帧之间的变化,比如人物走路是否自然、伞的位置是否稳定、背景是否乱跳、镜头运动是否符合逻辑。
所以,视频提示词不仅要写“画面里有什么”,还要写“画面如何变化”。
2. 提示词不是咒语,而是画面说明书
很多人写 AI 视频提示词时,只写一个很短的愿望,例如:
生成一个高级感短视频。
这类提示词的问题是信息太少。“高级感”可以是黑金商务风、极简科技风、电影胶片风、奢侈品广告风,也可以是干净的产品展示。模型不知道你真正想要哪一种,只能根据常见关联去猜。
更有效的提示词通常包含这些要素:
- 主体:画面中心是谁或什么?人物、产品、动物、建筑、风景?
- 动作:主体在做什么?走路、转身、飞行、打开、旋转、缓慢靠近?
- 场景:在哪里发生?街头、室内、海边、办公室、未来城市?
- 镜头:远景、中景、特写、俯拍、跟拍、推镜头?
- 风格:写实、动画、电影感、纪录片、赛博朋克、国风水墨?
- 光线:清晨自然光、黄昏逆光、霓虹灯、柔和棚拍光?
- 节奏:慢动作、平稳移动、快速切换、安静舒缓?
- 限制:不要模糊、不要文字变形、不要夸张表情等。
当然,不是每次都要把这些写满。短视频生成更适合抓住核心:主体、动作、场景、镜头、风格。其余内容按需求补充。
3. 画面描述要从“关键词”变成“可拍摄的场景”
AI 更容易理解具体画面,而不是抽象评价。
比如你想要“治愈感”,可以继续拆成:
- 场景:清晨阳台、阳光、绿植、白色窗帘;
- 主体:一只猫趴在木桌旁;
- 动作:微风吹动窗帘,猫缓慢眨眼;
- 镜头:固定镜头或轻微推近;
- 氛围:安静、温暖、柔和。
这样比只写“治愈系视频”更可控。
一个更完整的写法可以是:
清晨的室内阳台,一只橘猫趴在木桌旁,阳光从白色窗帘透进来,窗帘被微风轻轻吹动。镜头缓慢推近,画面温暖柔和,安静治愈,写实风格。
这段提示词并不复杂,但它已经告诉模型:画什么、在哪里、怎么动、镜头怎么走、整体感觉是什么。
4. 成片逻辑:AI 如何把文字变成视频
从通用原理看,AI 视频生成大致会经历几个理解环节。
语义理解
模型先判断提示词里有哪些关键元素。例如“雨夜街头、女孩、撑伞、行走、霓虹灯、电影感”,这些会被拆成画面概念。
如果提示词里存在冲突,例如“正午阳光强烈的雨夜街头”,模型可能会混合出奇怪画面,或者优先理解其中一部分。
画面构图
模型会推断主体位置、背景层次、镜头距离。你如果没写镜头,它可能自动选择常见构图;你如果写“人物半身特写,背景虚化”,它就更容易朝这个方向生成。
时间变化
视频比图片多了时间轴。模型需要让画面在几秒内发生变化:人物走动、云层飘动、镜头推进、光影变化等。
如果提示词只写“一个未来城市”,模型可能生成轻微镜头移动或灯光闪烁;如果写“镜头从高空缓慢下降,穿过未来城市的霓虹高楼”,运动方向就更明确。
风格统一
“写实电影感”“二次元动画”“黏土动画”“水墨风”这类描述会影响材质、色彩和细节。但风格词不能替代画面内容。只写“大片感”通常不如写清楚镜头、光线和场景。
5. 假设示例:同一个主题,提示词怎样影响结果
以下是假设示例,用来说明写法差异,不代表某个具体工具的固定输出。
模糊提示词
生成一个科技感视频。
可能的问题:
- 不知道主体是什么;
- 不知道是产品、城市、人物还是抽象背景;
- 不知道镜头运动;
- 结果可能变成常见蓝色光效、线路、粒子动画。
更清楚的提示词
黑色背景中,一台银色智能设备悬浮在画面中央,机身边缘有蓝色微光。镜头缓慢环绕设备一圈,背景有细微粒子漂浮,整体风格简洁、高级、科技感,写实产品广告风。
这个版本明确了主体、背景、运动方式、光效和风格,模型更容易生成接近“产品展示”的视频。
如果想要人物场景
夜晚的未来城市街道,一名穿银色外套的年轻人从霓虹灯下走过,地面有雨后反光。镜头跟随人物侧面缓慢移动,背景高楼灯牌虚化,电影感,冷色调。
这里“科技感”被转化为可视化元素:未来城市、银色外套、霓虹灯、雨后反光、冷色调。
6. AI 生成视频适合做什么
在不依赖具体产品功能的前提下,AI 视频生成通常更适合作为创意辅助,而不是完全替代成熟影视制作。
比较适合的用途包括:
- 短视频创意草稿:快速看一个画面想法是否成立;
- 分镜预览:把文字脚本变成粗略视觉方向;
- 氛围片段:生成背景、转场、情绪画面;
- 产品概念展示:辅助表达质感、光线和镜头感;
- 内容灵感探索:尝试不同风格、场景和视觉语言。
不太适合完全依赖的场景包括:
- 对人物身份、品牌细节、标志文字要求极高的视频;
- 需要严格复现真实事件或精确事实的内容;
- 需要长时间连续叙事、角色稳定和复杂运镜的专业成片;
- 对字幕、法律声明、产品参数等文字准确性要求高的画面。
这些不是说 AI 不能参与,而是更适合放在草稿、素材或辅助环节,再由人工剪辑、校对和后期处理。
7. 常见问题:为什么生成的视频“不像想象中那样”
提示词太抽象
“高级”“震撼”“好看”“爆款”都是评价,不是画面。可以把它们改写成具体元素:暗色背景、低角度镜头、强对比光、慢动作、金属质感、干净构图等。
主体和动作太多
如果一句提示词里同时写五个人、三种动作、多个场景切换,短视频模型可能难以稳定呈现。更稳妥的做法是一个片段只表达一个主要动作。
镜头运动不明确
“展示一座城市”可能生成普通风景;“镜头从高空俯拍缓慢下降,穿过城市高楼之间”则更像视频镜头。
风格词互相冲突
例如同时要求“真实纪录片风、梦幻二次元、水墨写意、赛博朋克”,模型可能混合出不稳定结果。除非你明确想要混搭,否则建议一次突出一种主风格。
对文字和细节期待过高
AI 视频中的招牌、字幕、手部细节、复杂图案等容易出现不稳定或变形。重要文字建议后期添加,不要完全依赖生成画面直接呈现。
8. 实用写法:一套简单的提示词结构
可以用这个结构起步:
主体 + 场景 + 动作 + 镜头 + 光线/色彩 + 风格 + 限制条件
例如:
一位穿白色衬衫的设计师坐在明亮工作室里,桌上放着草图和电脑。她抬头看向窗外,窗帘被微风吹动。镜头从桌面草图缓慢推到人物侧脸,清晨自然光,画面干净柔和,写实电影感。避免画面模糊,避免多余人物。
这类写法的好处是:
- 主体明确;
- 动作简单;
- 镜头可想象;
- 氛围具体;
- 限制条件不复杂。
如果第一次结果不理想,不建议一次性大改全部提示词。可以只改一个变量,比如先固定主体和场景,再调整镜头;或者固定风格,只改动作。这样更容易判断是哪一部分影响了成片。
9. 如何判断生成结果是否可用
看 AI 视频是否可用,不只看“第一眼好不好看”,还要检查几个细节:
- 主体是否稳定:人物、产品或核心物体有没有变形、消失、突然变化;
- 动作是否连贯:走路、转身、镜头移动是否自然;
- 场景是否一致:背景有没有无意义跳变;
- 风格是否统一:色彩、质感、光线是否前后冲突;
- 是否有不可用细节:文字乱码、手部异常、品牌标识错误等;
- 是否符合用途:适合作为成片、草稿,还是只能当灵感参考。
如果结果接近但不够准,可以根据问题反向修改提示词:
- 主体不突出:增加“主体位于画面中央”“背景虚化”;
- 动作混乱:减少动作,只保留一个主要动作;
- 风格跑偏:删除多余风格词,保留一个主风格;
- 镜头太乱:改成“固定镜头”或“缓慢推近”;
- 文字不准:避免让 AI 直接生成关键文字,改为后期添加。
10. 结论:把它当作可迭代的视觉草稿工具
理解豆包 AI 生成视频,关键不是记住某几个“万能提示词”,而是理解文字如何被转化为画面:主体决定看什么,动作决定怎么变化,场景决定在哪里,镜头决定怎么看,风格决定像什么。
更实际的使用方式是:先用清楚的画面描述生成第一版,再根据结果逐步调整。不要把 AI 视频当作一次命中、完全可控的传统拍摄流程,而要把它看成一个能快速产出视觉草稿、帮助探索创意方向的工具。这样使用时,期待更合理,提示词也会更有效。
Ai菜鸟网。发布者:AI小管家,转载请注明出处:https://www.alyyhw.com/29509.html