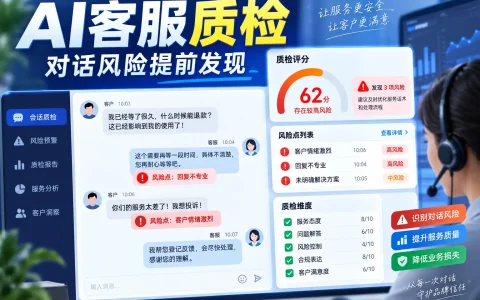
AI 客服质检智能体的价值不是“自动打一个分”,而是把规则逐项应用到对话,并告诉复核员证据在哪。一个可审计的质检结果不能只有总分,至少要保留规则、结论、原文证据和人工状态。
第一步:把模糊标准改成可判断规则
“服务态度好”很难稳定判断。把它拆成可观察行为,例如:是否先确认订单;是否承诺了政策外退款;客户说要投诉时是否转人工;是否泄露其他客户信息。
| rule_id | 通过 | 失败 | 不适用 |
|---|---|---|---|
| R01 身份核对 | 处理账号问题前完成规定核验 | 未核验就改信息 | 仅咨询公开商品信息 |
| R02 退款承诺 | 引用现行政策并说明下一步 | 承诺政策外到账时间 | 无退款话题 |
| R03 人工升级 | 投诉或安全问题转人工 | 继续自动劝说 | 普通咨询 |
第二步:要求输出证据,不允许概括代替原文
{
  "conversation_id": "T001",
  "checks": [{
    "rule_id": "R02",
    "result": "pass|fail|na|uncertain",
    "evidence_quote": "必须逐字来自对话",
    "evidence_turn": 8,
    "reason": "一句话解释",
    "needs_human": true
  }],
  "overall_risk": "low|medium|high"
}
使用支持 JSON Schema 的结构化输出,可以限制枚举值、必填字段和数据类型;但结构正确不等于判断正确。程序还要检查 evidence_quote 是否真的出现在指定轮次,不存在就拒收。
第三步:建立最小验证集
先用 50 到 100 条已经人工标注的脱敏对话做验证集。每条都保留规则版本和判定依据,覆盖明显通过、明显失败、边界案例、短对话、长对话、方言或错别字。
- 冻结规则版本,例如 qa_rules_v1。
- 两名复核员先独立标注分歧样本,再形成金标。
- 运行智能体,保存原始输出和模型版本。
- 按规则统计漏报与误报,不能只看总体准确率。
- 修改规则或提示词后重跑同一验证集。
验证时分别计算高风险漏报、普通误报和证据引用错误,任何引用不存在的原句都必须判失败。对于退款、隐私、威胁和安全问题,高风险漏报应单独列出,不被大量普通通过样本稀释。
第四步:用分层抽样保持人工控制
- 100% 复核 high risk 和 uncertain。
- 按客服、渠道、班次和问题类型抽取普通样本。
- 新规则上线初期提高抽样率,稳定后再逐步调整。
- 将人工纠正回写为评估数据,不让模型直接修改正式规则。
NIST AI RMF 强调以治理、映射、测量和管理形成持续循环。落地到客服质检,就是规则有负责人、风险有分级、结果可测量、发现问题能回到规则和流程。
上线前检查
- 对话已脱敏,访问权限按岗位最小化。
- 每次运行记录规则版本、模型版本和时间。
- 失败与超时显示“未完成”,不能默认通过。
- 人工更改有审计记录,原始结果不可覆盖。
- 先选一个最稳定的规则,例如“是否核对订单号后再处理退款”,为它写出通过、失败和不适用样例。
结构化输出只能约束字段形状,不能保证评分事实正确;高风险结论仍需要人工复核。示例没有连接真实工单系统,也没有代表你的业务规则或质检准确率。
来源与适用范围
- OpenAI Structured Outputs 指南:用于核对 JSON Schema 能约束字段结构的范围
- NIST AI 风险管理框架:用于核对治理、测量和持续风险管理原则
以上页面核验于 2026-10-01。产品界面、套餐和能力会变化,实际使用时以当前账号界面与官方说明为准。
Ai菜鸟网。发布者:AI小管家,转载请注明出处:https://www.alyyhw.com/32132.html